 文武科技柜
Unlimited-OCR-2:百度开源新一代AI文字识别模型,支持超长PDF文档解析,附在线体验和部署教程
文章目录
平时处理 PDF、扫描件或者图片资料,最麻烦的是什么?
不是文件打不开,而是里面的文字没办法直接复制。
特别是几百页的合同、论文、技术手册,如果一页页截图识别,再手动整理内容,非常浪费时间。
最近,百度开源了新一代 OCR 模型:Unlimited-OCR-2。
它不仅能够识别图片中的文字,还重点提升了超长文档解析能力,可以一次处理多页内容,并尽量利用跨页上下文还原文档。
而且提供了免费开源模型和在线体验入口。
一、Unlimited-OCR-2是什么?
Unlimited-OCR-2 是百度推出的视觉文档解析模型,于2026年10月27日正式开源。
OCR 的意思是光学字符识别。
传统 OCR 主要解决的是:
把图片里的文字识别出来。
但面对一本长篇 PDF,问题就复杂了。
例如一个表格跨越了好几页,或者上下两页的段落需要连起来理解,简单逐页识别就可能丢失关联。
Unlimited-OCR-2 的核心思路是:
不再局限于单页识别,而是让模型能够连续解析超长文档。
上传文档或页面图片
        ↓
识别文字及页面内容
        ↓
结合跨页上下文
        ↓
连续生成解析结果
        ↓
整理为可处理的文本
它更适合长篇论文、技术资料、扫描文档等场景。
二、功能特征
1. 支持超长文档解析
这是 Unlimited-OCR-2 最重要的升级。
传统模型处理长文档时,随着内容越来越多,计算和显存开销可能迅速增加。
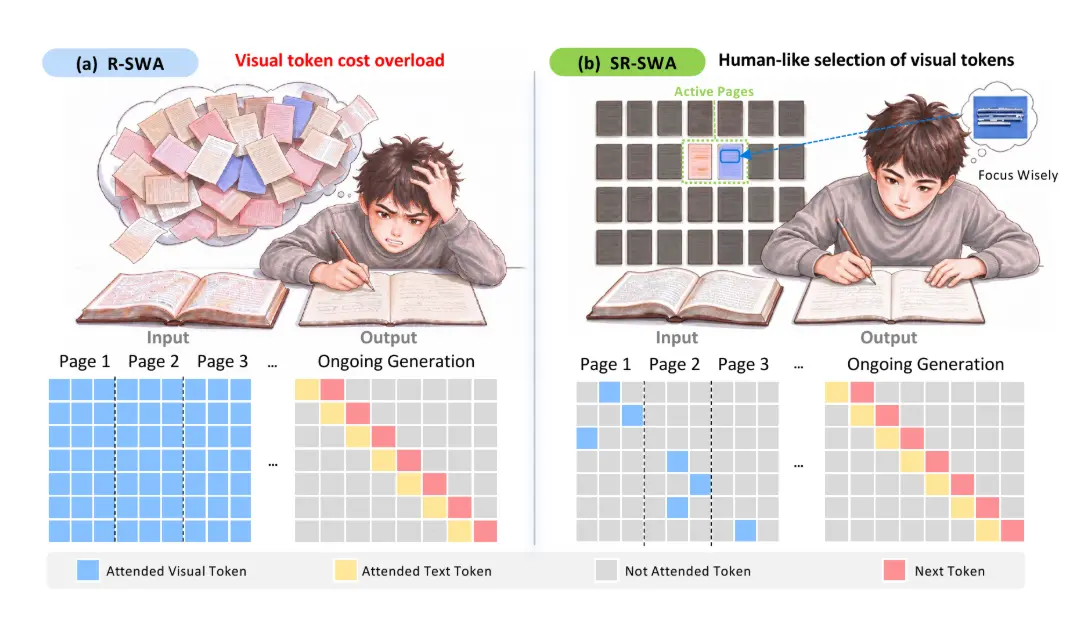
Unlimited-OCR-2 引入了 SR-SWA(稀疏引用滑动窗口注意力)。
简单理解,就是不让模型每次都重新处理全部历史内容,而是保留有限的关键参考信息。
这样可以控制长文档推理过程中的计算和内存开销。
不过,实际处理长度仍受显存、输出限制和部署配置影响。
2. 多页内容一次识别
官方提供 infer_multi 接口。
可以将多张页面图片按顺序提交,让模型在同一次请求中解析整份文档。
相比完全独立地识别每一页,这种方式可以利用页面之间的关联信息。
3. 支持单页高精度解析
如果只是识别一张截图、扫描页或者表格图片,也可以使用单页识别功能。
官方单页模式默认采用动态切图,对页面中的不同区域进行处理。
4. 支持多种语言文档
模型面向多语言视觉文字识别任务。
可以用于中文、英文及其他语言的文档解析。
不过,小字体、模糊图片、特殊排版和复杂表格仍然可能出现识别错误。
5. 支持本地部署和API服务
Unlimited-OCR-2 不只是在线演示。
开发者可以通过 Transformers 在本地运行推理,也可以使用官方适配的 SGLang 服务端方案。
方便将识别能力接入文档管理、知识库和自动化工作流。
三、Unlimited-OCR和Unlimited-OCR-2有什么区别?
| 对比 | Unlimited-OCR | Unlimited-OCR-2 |
|---|---|---|
| 发布时间 | 2026年6月 | 2026年10月 |
| 主要定位 | 长文档OCR解析 | 超长文档连续解析 |
| 核心升级 | 长文档识别能力 | SR-SWA注意力机制 |
| 多页上下文 | 面向长文档处理 | 进一步强化 |
| 适用场景 | 常规与长篇文档 | 更长的多页文档 |
| 开源权重 | 已提供 | 已提供 |
百度官方表示,新版本在 MPDocBench 和 MarathonDocBench 等长文档评测中取得了领先成绩。
这些属于特定测试条件下的结果,实际效果仍需要根据自己的文件进行验证。
四、在线体验教程:无需安装
如果只是想试试识别效果,最简单的办法就是使用 Hugging Face 在线演示。
第一步:打开体验页面
访问:
https://huggingface.co/spaces/baidu/Unlimited-OCR-2
该页面名称为 Unlimited OCR Works 2 Studio。
第二步:上传测试文件
按照页面提供的输入方式,上传支持的图片或文档。
建议第一次先使用一张清晰的截图或扫描页。
如果页面支持多页文档,再尝试较长的文件。
第三步:查看识别结果
提交识别后,查看输出的文字和页面结构。
重点检查:
- 有没有漏字或错字
- 段落顺序是否正确
- 表格数据有没有错位
- 多页内容有没有遗漏
在线演示可能受到运行资源、排队和上传限制,不适合直接当成无限量的批量转换服务。
另外,涉及合同、财务资料等敏感内容时,不建议直接上传到公开演示环境。
五、本地部署教程
如果希望离线处理文档,或者接入自己的软件,可以选择本地部署。
1. 环境要求
官方 Transformers 示例测试环境如下:
| 项目 | 官方测试配置 |
|---|---|
| Python | 3.10 |
| PyTorch | 2.13.0 |
| Transformers | 4.52.1 |
| GPU | NVIDIA A800 80GB |
| 推理精度 | BF16 |
这里的 A800 80GB 是官方测试设备,不能直接理解为模型运行的最低硬件要求。
普通电脑是否能运行,取决于显存、模型加载方式和具体配置。
2. 安装依赖
先准备 Python 环境,再按照项目 README 安装对应依赖:
pip install torch==2.13.0 torchvision pillow transformers==4.52.1 huggingface-hub==0.36.0 tokenizers==0.21.4 addict==2.4.0 einops==0.8.2 easydict==1.13PyTorch 还需要与本机 CUDA 环境匹配。
3. 加载模型
新建一个 Python 文件:
import torch
from transformers import AutoModel, AutoTokenizer

model_name = "baidu/Unlimited-OCR-2"

tokenizer = AutoTokenizer.from_pretrained(
    model_name,
    trust_remote_code=True
)

model = AutoModel.from_pretrained(
    model_name,
    trust_remote_code=True,
    use_safetensors=True,
    torch_dtype=torch.bfloat16
).eval().cuda()
首次运行时,程序会从 Hugging Face 获取模型文件。
其中 trust_remote_code=True 允许执行模型仓库提供的自定义代码,建议先检查来源和代码内容。
4. 识别单张图片
text = model.infer(
    tokenizer,
    image_file="test.jpg",
    output_path="output/single",
    save_results=True
)

print(text)
将 test.jpg 替换成自己的图片路径即可。
5. 识别多页文档
例如有7张按顺序编号的文档图片:
pages = [
    f"your_doc/page_{i}.jpg"
    for i in range(1, 8)
]

text, num_tokens = model.infer_multi(
    tokenizer,
    image_files=pages,
    output_path="output/multi",
    save_results=True
)

print(text)
模型会按照传入的图片顺序返回解析结果。
如果原文件是 PDF,可以先把 PDF 页面转换为图片,再调用多页识别接口。
对于需要搭建正式服务的开发者,官方推荐使用定制的 SGLang 方案;具体依赖和启动参数见 GitHub README,不能直接假定普通版本的 SGLang 已完整兼容。
六、适合哪些使用场景?
扫描PDF转文字
将扫描件中的文字提取出来,方便复制、搜索和后续整理。
论文与技术文档解析
处理包含多页内容的研究资料、产品说明书和技术手册。
企业知识库建设
将纸质资料或扫描文档转换成可检索文本,再接入 RAG 知识库。
财务与业务资料整理
提取报表截图、合同扫描件和业务文档中的内容。
需要特别注意,OCR 识别结果不能直接替代财务数据核对。
AI自动化工作流
可以将 Unlimited-OCR-2 作为文档识别环节,后续交给其他 AI 模型完成分类、摘要、检索和数据整理。
七、免费吗?有哪些限制?
Unlimited-OCR-2 的 GitHub 代码和 Hugging Face 模型均采用 MIT 开源许可证。
开发者可以在符合许可证要求的前提下使用、修改和集成。
不过,免费开源不代表没有成本。
本地运行需要计算硬件;部署在线接口可能产生 GPU 服务器费用;Hugging Face 在线演示也可能受到资源限制。
此外,超长文档识别并不保证完全准确。对于合同金额、财务数字、公式和复杂表格,建议保留人工校对流程。
结语
Unlimited-OCR-2 的价值,不只是让 AI 识别图片里的文字。
它更重要的升级,是让 OCR 从单页识别,逐渐走向连续的长文档解析。
通过 SR-SWA 机制,模型可以在有限资源下更高效地处理不断增长的文档内容。
对于普通用户,可以先使用 Hugging Face 在线体验。
对于开发者,则可以通过 Transformers 或 SGLang 将模型接入自己的文档处理系统。
OCR的下一步,不只是认出每一个字,而是更完整地还原一整份文档。
网址
你觉得这篇文章怎么样?
共有 0 条评论